
 Photo : Andrea Piacquadio · Pexels
Exemple : la maintenance prédictive IA dans une ETI industrielle
Une situation type, construite pour illustrer la démarche : de la cartographie des machines à l'intégration dans la GMAO, avec les écueils à anticiper. Aucun client réel, aucun résultat chiffré.
Nos clients types
Exemple de situation. Cet article décrit une situation type, construite pour illustrer la démarche d'un projet de maintenance prédictive. Il ne s'agit pas d'un client réel : aucun chiffre de résultat n'est avancé, et les détails (type d'usine, machines, outils) sont volontairement génériques.
#Le problème : des arrêts non planifiés qui coûtent cher
Prenons une ETI industrielle solide : un fabricant de pièces métalliques de précision, des clients automobiles et aérospatiaux exigeants, un carnet de commandes stable. Et pourtant, un chiffre revient à chaque comité de direction : le nombre d'heures d'arrêts non planifiés sur les lignes de production.
Sur des pièces à forte valeur ajoutée, chaque heure d'arrêt non planifié a un coût direct : production perdue, heures supplémentaires pour rattraper, pénalités contractuelles sur les délais de livraison, mobilisation en urgence des techniciens au détriment de la maintenance planifiée. La maintenance curative, la plus coûteuse et la moins maîtrisable, devient la cible évidente.
La direction a déjà tenté plusieurs approches : augmenter la fréquence de la maintenance préventive (les coûts montent, les arrêts non planifiés restent stables), réorganiser les équipes de quart, investir dans une GMAO (utile, mais insuffisante sans prédiction). Le diagnostic est simple : sans capacité à anticiper la défaillance avant qu'elle se produise, le cercle maintenance curative, arrêt, rattrapage ne se brise pas.
C'est ce que permet l'IA prédictive en maintenance industrielle : passer d'une logique réactive (on intervient quand la panne arrive) à une logique prédictive (on intervient quand le modèle détecte les signaux précurseurs d'une défaillance imminente).
Le projet démarre avec un objectif de réduction des arrêts non planifiés, défini avec la direction avant le premier développement, et un indicateur de référence relevé avant le projet.
#Étape 1 : diagnostic, cartographie des machines, capteurs et données
Avant d'écrire une ligne de code, il faut passer du temps sur le terrain. Le diagnostic est la phase la plus critique d'un projet de maintenance prédictive, et la plus souvent bâclée.
Inventaire des lignes de production. Les lignes sont hétérogènes : fraiseuses CNC, tours automatiques, centres d'usinage, rectification, contrôle dimensionnel. L'âge du parc varie beaucoup. Première découverte fréquente : seule une partie des machines dispose de capteurs connectés, et parmi elles, les données ne sont pas toujours collectées de façon continue.
Les machines sans connectivité nécessitent une instrumentation physique, avec un coût et un délai à intégrer au cadrage.
Analyse des données disponibles. On extrait l'historique des capteurs existants : température des moteurs, vibrations (accéléromètres), courant absorbé, pression hydraulique, compteurs de cycles. On mesure la couverture temporelle réelle (trous de collecte, notamment le week-end et pendant les arrêts planifiés) et la part de valeurs aberrantes ou manquantes. Un travail de nettoyage sérieux s'impose avant tout entraînement.
Corrélation données et historique des pannes. La GMAO contient l'historique des interventions. En le croisant avec les données capteurs, on identifie les signaux précurseurs les plus fiables. Par exemple, une dérive progressive de la signature vibratoire sur un axe précède souvent une défaillance de roulement de broche, et une dérive de la consommation de courant du moteur principal peut annoncer une défaillance de transmission.
Décision d'architecture. À partir de ce diagnostic, on sélectionne quelques lignes pilotes : les machines les plus critiques, celles dont les pannes sont les plus coûteuses, et celles dont l'historique de pannes est le plus riche et le plus régulier, idéal pour l'entraînement. Pour les machines non instrumentées, l'installation de capteurs est planifiée en parallèle du développement du modèle.
#Étape 2 : l'architecture IA
L'architecture s'appuie sur quatre composants, chacun répondant à une contrainte précise du contexte industriel.
Une passerelle et un service de collecte (par exemple Azure IoT Hub). Il assure la collecte et le routage des données capteurs en temps quasi réel. Chaque machine instrumentée envoie ses métriques à intervalle régulier via des passerelles IoT industrielles compatibles avec le réseau OT de l'usine. Le choix du cloud dépend du contexte : accords existants, gouvernance, exigences de certification des donneurs d'ordre.
Une base de séries temporelles. Elle stocke et interroge les données par machine, type de signal et horodatage. L'historique reconstitué y est ingéré lors de la phase de mise en place. Elle permet aussi à l'équipe de maintenance de faire des requêtes ad hoc, par exemple visualiser la dérive d'un signal sur plusieurs semaines.
Un modèle prédictif (par exemple un réseau LSTM). C'est le cœur du système. Ce type de réseau de neurones récurrent convient bien aux séries temporelles industrielles : il apprend les motifs temporels complexes dans les données vibratoires, thermiques et électriques, et détecte les écarts par rapport aux comportements appris.
On entraîne en général un modèle par famille de machines plutôt qu'un modèle global, pour gagner en précision. L'architecture IA appliquée à l'industrie 4.0 décrit ces choix plus en détail.
Un tableau de bord opérationnel. Une interface web accessible depuis les postes de supervision et les tablettes des responsables de maintenance : trois niveaux d'alerte visuels (vert, orange, rouge), un horizon de prédiction (délai estimé avant défaillance probable) et une recommandation d'action. L'intégration avec la GMAO permet de créer automatiquement un ordre de travail préventif à partir d'une alerte, avec affectation au technicien de permanence.
L'architecture est pensée pour évoluer : des agents IA peuvent ensuite s'y greffer pour automatiser des décisions de planification, optimiser les stocks de pièces détachées ou suggérer des fenêtres d'intervention en fonction du planning de production.
#Étape 3 : déploiement des capteurs et préparation des données
La phase d'instrumentation et de préparation des données dépasse presque toujours le planning initial sur un projet industriel IoT. Mieux vaut le prévoir.
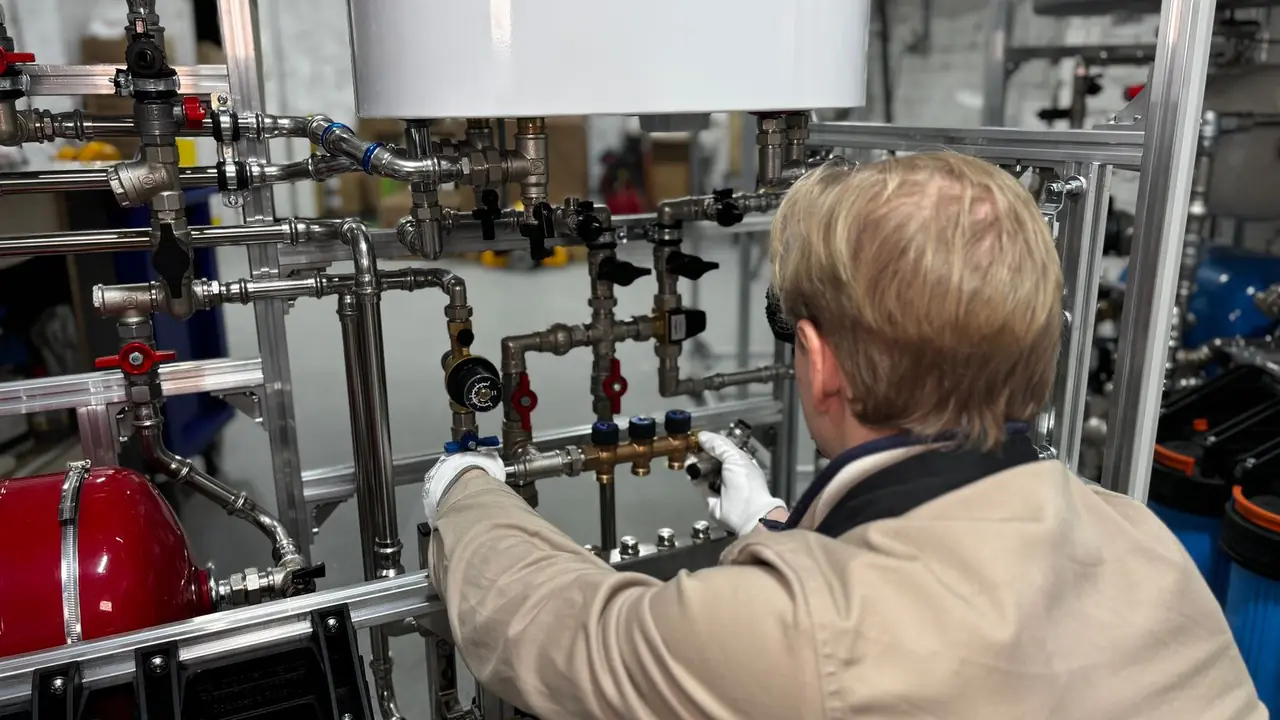
Installation des capteurs. Elle demande une coordination précise avec le planning de production pour limiter les arrêts machines. Typiquement, une équipe intervient le week-end pour poser les accéléromètres triaxiaux, les capteurs de température infrarouge sur les roulements et les pinces de mesure de courant, puis paramètre les passerelles.
Complication fréquente : certaines armoires électriques sont incompatibles avec le protocole prévu (OPC-UA par exemple) et imposent un autre protocole, avec un coût supplémentaire à anticiper.
Reconstitution de l'historique. Pour les machines nouvellement instrumentées, il n'existe pas de données numériques historiques. On exploite alors l'historique papier et celui de la GMAO : dates et types d'interventions, pièces remplacées, temps d'arrêt, commentaires des techniciens. Ce pseudo-historique permet d'initialiser le modèle en utilisant les fenêtres de temps autour de chaque intervention comme signal d'entraînement.
Nettoyage des données. C'est la phase la plus ingrate et la plus décisive : suppression des valeurs physiquement impossibles, interpolation des trous courts, marquage des trous longs comme données manquantes exclues de l'entraînement, normalisation par machine pour corriger les dérives de calibration des capteurs.
Les méthodologies de déploiement d'un projet IA en 7 étapes prévoient cette phase de qualité des données comme un livrable à part entière, avec des métriques de qualité documentées.
#Étape 4 : entraînement du modèle sur quelques lignes pilotes
Cette étape est celle de la première vérité : l'entraînement du modèle et la confrontation de ses prédictions à la réalité.
Configuration de l'entraînement. Pour chaque famille de machines pilotes, un modèle distinct est entraîné sur la majeure partie de l'historique, les derniers mois servant de jeu de validation. La variable cible est la probabilité de défaillance dans les prochaines 24 heures. Le seuil d'alerte est fixé d'abord assez bas pour maximiser le rappel : mieux vaut quelques fausses alarmes que de manquer une panne réelle.
Le problème des faux positifs. Les premières semaines de fonctionnement en mode surveillance (sans action déclenchée) révèlent presque toujours un problème : une part importante des alertes ne correspond à aucune défaillance réelle. La réaction des techniciens est immédiate et prévisible : « le système n'est pas fiable, on continue comme avant ».
La cause racine est fréquente : le modèle confond des comportements opératoires légitimes (changement de programme pièce, montée en régime après l'arrêt du week-end) avec des signaux précurseurs de panne. Les données d'entraînement ne contiennent pas assez de marqueurs d'état opératoire pour distinguer ces contextes.
Recalibrage. Trois actions correctives, en parallèle : enrichir le jeu d'entraînement avec les logs de planification de la GMAO (arrêts programmés, changements de série, mises en chauffe), ajouter une couche de contexte opératoire dans les variables du modèle (temps depuis la dernière mise en marche, type de programme en cours), et relever le seuil d'alerte pour réduire les alertes sur les situations ambiguës.
Le budget d'un projet IA en entreprise doit intégrer ces itérations de recalibrage : elles ne sont pas des imprévus, elles sont inhérentes à tout projet de machine learning en production.
→ Prêt à passer à l’action ? Réservez un appel découverte de 15 minutes avec notre équipe pour analyser votre projet — sans engagement.
#Étape 5 : extension, intégration GMAO, alertes automatiques
Avec un modèle recalibré et un taux de faux positifs en baisse, on bascule vers le déploiement complet.
Extension progressive. Les lignes restantes sont intégrées par vagues successives, espacées de quelques semaines. Cette progressivité est délibérée : elle permet d'ajuster le modèle sur chaque nouvelle famille de machines avant la vague suivante, et de garder une charge de support gérable pour l'équipe projet. Certaines familles, comme les centres d'usinage multi-axes, demandent un modèle spécifique, car leur signature vibratoire rend les modèles existants inadaptés.
Intégration à la GMAO. C'est souvent le chantier technique le plus complexe de cette phase. L'objectif : quand le modèle génère une alerte rouge, un ordre de travail préventif est créé automatiquement dans la GMAO avec la machine concernée, le type de défaillance probable, les pièces de rechange recommandées (issues de l'historique de pannes similaires) et une fenêtre d'intervention suggérée pour limiter l'impact sur le planning de production.
Avec SAP PM, cela passe par les API standard (BAPI). Le maillage entre IA prédictive et ERP/GMAO est un sujet à part entière : c'est souvent là que se joue l'adoption réelle par les équipes.
Formation et conduite du changement. La résistance des techniciens, qui apparaît avec les faux positifs, demande un programme structuré : des ateliers avec l'équipe de maintenance, une démonstration en conditions réelles sur les lignes pilotes, l'explication de la logique du modèle (« voici pourquoi le système a déclenché une alerte sur cette machine à ce moment ») et la présentation de cas documentés où le modèle a détecté une défaillance avant qu'elle se produise.
Le change management dans les projets IA est l'un des facteurs de succès les plus sous-estimés dans les projets industriels, souvent plus que la qualité du modèle lui-même.
Alertes automatiques. En plus du tableau de bord, un canal SMS ou notification push est configuré pour les techniciens d'astreinte (nuit et week-end), avec un lien direct vers la fiche machine et le contexte de l'alerte. Cette fonctionnalité, souvent demandée par les techniciens eux-mêmes lors des ateliers, contribue à l'adoption.
Un taux de faux positifs jugé acceptable avec l'équipe. Le seuil acceptable se définit avec l'équipe de maintenance, pas contre elle : c'est elle qui vit avec les alertes. La sécurité et la fiabilité des systèmes IA en production incluent cette dimension de calibration continue.
#Étape 6 : mesurer l'effet
Les derniers mois du projet sont ceux de la mesure. Le modèle est stable, les équipes sont formées, les intégrations GMAO fonctionnent.
Ce qu'on suit, par rapport à l'indicateur de référence relevé avant le projet :
- les heures d'arrêts non planifiés, par famille de machines (les machines les mieux instrumentées, avec un signal précurseur net, donnent en général les premiers résultats) ;
- le taux de disponibilité des machines, suivi directement dans la GMAO, qui agrège toutes les causes d'indisponibilité ;
- le coût de maintenance, décomposé : interventions curatives d'urgence, pénalités contractuelles sur retards de livraison, stocks de pièces détachées (commandes anticipées plutôt qu'achats d'urgence) ;
- la production récupérée sur les heures d'arrêt évitées.
Une règle de prudence : on ne retient dans le calcul que les économies directement vérifiables dans les systèmes (GMAO, comptabilité analytique), sans projection spéculative. L'article dédié au calcul du ROI d'un projet IA détaille la méthode. Dans ce type de projet, on mesure l'effet pendant le pilote, avant de décider d'aller plus loin.
#Ce qui ne fonctionne pas du premier coup
Tout projet honnêtement documenté intègre ses zones de friction. En voici quatre fréquentes.
Le pic de faux positifs au démarrage : une crise évitable. Il n'est pas une surprise technique, mais la conséquence prévisible de l'absence de contexte opératoire dans les données d'entraînement. Ce qu'il faut faire dès le diagnostic : intégrer les logs de planification de la GMAO dans les variables du modèle avant le premier entraînement, pas après le premier constat d'échec.
Le contexte opératoire est un prérequis de l'entraînement dans notre méthodologie de déploiement IA industrielle, pas un ajout après coup.
La résistance des techniciens de maintenance. « Le système me dit qu'il va tomber en panne, mais moi je l'entends fonctionner normalement » : cette phrase résume un problème de fond. Les techniciens expérimentés ont une expertise sensorielle (écoute, toucher, observation visuelle) que le modèle ne valide pas explicitement.
La solution n'est pas de nier cette expertise, mais de la compléter. Une fois les ateliers de formation faits, les techniciens utilisent les alertes comme point de départ d'une inspection physique, pas comme un verdict automatique. L'IA est un outil d'aide à la décision, pas un oracle : c'est central dans notre approche du change management des projets IA en entreprise.
Les données manquantes le week-end. Pour limiter les coûts de transfert, on est tenté de réduire la fréquence d'échantillonnage pendant les arrêts du week-end. Or certaines pannes se déclenchent précisément lors des remises en chauffe du lundi matin, une fenêtre où la continuité des données de la fin de semaine précédente est critique.
Mieux vaut maintenir l'échantillonnage en continu, 24 h sur 24, 7 jours sur 7. Pour calibrer ce type de budget projet IA, les coûts d'infrastructure cloud se calculent sur les cas extrêmes, pas sur les cas moyens.
Les engagements de performance du modèle. Il est tentant d'inscrire au contrat un engagement de résultat du type « moins de X % de faux positifs ». La contractualisation des KPI et SLA d'un projet IA est un sujet complexe : un modèle de machine learning en production est un système vivant, qui dérive avec les conditions réelles.
Un engagement de processus (suivi mensuel, recalibrage prévu au contrat si les faux positifs dépassent un seuil convenu) est plus sain qu'un engagement de résultat figé.
#Cadrer le budget et le retour sur investissement
Le budget d'un projet de ce type se compose de postes bien identifiés : diagnostic et architecture, développement des modèles et du pipeline IoT, intégration à la GMAO, tableau de bord et formation, capteurs supplémentaires et installation, puis un coût récurrent (infrastructure cloud et maintenance du modèle).
Le poids de chaque poste dépend du nombre de machines à instrumenter, de l'âge du parc, de l'état de la GMAO et de la qualité des données. Il se chiffre sur devis, après un premier échange et un diagnostic.
Pour le retour sur investissement, la méthode compte plus que le chiffre : un état de référence relevé avant le projet, des économies vérifiables dans les systèmes de l'entreprise, et une décision d'extension prise sur les mesures du pilote. Pour aller plus loin sur la définition et les cas d'usage des agents IA industriels, notre article dédié couvre les extensions possibles de ce type de projet.
#Conclusion : ce que cette situation enseigne
Cette situation type réunit des conditions présentes dans beaucoup d'ETI industrielles : un problème documenté, des données partiellement disponibles, une GMAO en place et une équipe de maintenance compétente. Ces conditions suffisent pour lancer un pilote de maintenance prédictive avec un risque maîtrisé.
Cinq enseignements transmissibles :
1. La qualité des données prime sur la sophistication du modèle. Un modèle correct sur des données propres surpasse un modèle sophistiqué sur des données sales. Le nettoyage et la contextualisation des données ne sont pas optionnels.
2. Le contexte opératoire doit être intégré dès l'entraînement. Sans distinguer « machine en changement de série » de « machine en dérive anormale », tout modèle de détection d'anomalies industrielles génère des faux positifs inacceptables. Cette leçon coûte cher à apprendre après coup.
3. L'intégration GMAO est le multiplicateur de valeur. Un modèle qui génère des alertes dans un tableau de bord isolé a une valeur limitée. Un modèle qui crée automatiquement des ordres de travail avec les pièces recommandées change réellement le flux de travail des équipes.
4. Le change management détermine l'adoption. Les techniciens ont une expertise sensorielle légitime. L'IA ne la remplace pas, elle l'augmente. Ce positionnement doit se retrouver dans la formation, l'interface et le mode opératoire quotidien.
5. Commencer par les lignes les plus critiques. Concentrer le pilote sur les machines dont les pannes sont les plus coûteuses rend l'effet visible plus vite, ce qui facilite la décision de poursuivre le déploiement.
Pour explorer comment déployer ce type de projet dans votre contexte, nos services d'IA industrielle sur mesure partent d'un audit technique de votre parc machines, de vos données disponibles et de vos coûts de maintenance actuels. L'exemple de situation : agent IA pour une ETI logistique illustre une approche similaire dans un secteur différent.
Photos : МОБО Модульные Котельные, Cemrecan Yurtman sur Pexels.
Questions & réponses
Questions fréquentes : maintenance prédictive IA en industrie
Il faut un historique de données capteurs continu sur une durée suffisante (souvent une à deux années), avec assez d'événements de panne pour que le modèle apprenne les signaux précurseurs. Un modèle fiable est plus facile à obtenir sur des machines à pannes fréquentes et à signal précurseur net que sur des machines qui tombent rarement en panne. Pour les machines dont l'historique est sur papier, sans données capteurs numériques, une approche hybride est possible : les logs GMAO (dates et types d'interventions) servent de variable cible, et les capteurs installés récemment fournissent les données d'entraînement sur une période plus courte. Un jeu de données de qualité sur une période courte vaut mieux qu'un long historique mal collecté.
La maintenance préventive est basée sur le temps ou les compteurs de cycles : on intervient à intervalles fixes, indépendamment de l'état réel de la machine. C'est mieux que la maintenance purement réactive, mais cela génère des interventions inutiles sur des machines en bon état et peut manquer des défaillances qui surviennent entre deux interventions planifiées. La maintenance prédictive IA est basée sur l'état réel de la machine, estimé en continu à partir des données capteurs (vibrations, température, courant) analysées par un modèle de machine learning. On intervient quand le modèle détecte des signaux précurseurs d'une défaillance imminente — ni trop tôt (gaspillage), ni trop tard (panne). Dans la pratique, on combine les deux : préventive pour les maintenances réglementaires, prédictive pour les défaillances évitables.
Le coût dépend du nombre de lignes et de machines, et il se chiffre sur devis, après un premier échange et un diagnostic. Les postes sont : le diagnostic et l'architecture, l'instrumentation physique des machines qui ne sont pas connectées (variable selon leur complexité), le développement du modèle et du pipeline de données, l'intégration à la GMAO (plus longue si la GMAO est ancienne ou peu documentée), le tableau de bord et la formation des équipes. S'y ajoutent un coût récurrent d'infrastructure cloud et de maintenance du modèle. La qualité des données historiques pèse aussi : des données propres demandent moins de travail de nettoyage.
Les faux positifs sont le principal facteur de perte de confiance des équipes de maintenance dans un système IA. Trois actions se combinent : (1) enrichir le jeu d'entraînement avec le contexte opératoire (état de la machine, type de programme en cours, temps écoulé depuis la dernière mise en route) — c'est en général la correction la plus efficace ; (2) ajuster le seuil d'alerte pour ne déclencher que les situations à forte probabilité de défaillance ; (3) entraîner des modèles distincts par famille de machines plutôt qu'un modèle global. Un seuil trop élevé réduit les fausses alertes mais risque de manquer des pannes réelles : le bon réglage se décide avec les techniciens, pendant le pilote.
Oui, et c'est même l'intégration prioritaire pour tirer parti du système. L'intégration GMAO permet de fermer la boucle : le modèle détecte une anomalie, un ordre de travail préventif est créé automatiquement dans la GMAO avec la machine, le type probable de défaillance et les pièces de rechange recommandées, le technicien intervient, l'intervention est enregistrée, et ces nouvelles données enrichissent le modèle. Pour SAP PM, l'intégration utilise les BAPI standard (par exemple BAPI_ALM_ORDER_MAINTAIN) ou l'API REST SAP si votre version le permet. Pour Infor EAM, des API REST sont exposées. Les GMAO anciennes sans API demandent une couche d'abstraction (middleware) et un délai d'intégration plus long.
Azure IoT Hub supporte nativement les protocoles MQTT, AMQP et HTTPS pour les passerelles IoT. Pour les machines d'usinage, la connexion se fait via des passerelles IoT (Siemens IOT2050, Advantech, Phoenix Contact) qui font le pont entre les protocoles machine et Azure IoT Hub. Les protocoles machine courants sont : OPC-UA (standard moderne, supporté par la plupart des commandes numériques récentes), Modbus TCP/RTU (protocole ancien très répandu), PROFINET (Siemens) et EtherNet/IP (Allen-Bradley/Rockwell). Pour les machines très anciennes sans connectivité réseau, des capteurs externes (accéléromètres, capteurs de courant) peuvent être installés et connectés via une passerelle indépendante de l'automate machine : c'est une approche courante sur les lignes anciennes.
Parlons de votre projet
Un devis chiffré, sans engagement
Décrivez votre besoin en deux minutes : un consultant senior vous répond avec une première estimation et les prochaines étapes.
- Réponse sous 24 h ouvrées
- Sans engagement
- Un consultant senior vous répond